团队准备“验证新版体验”,测试时却只问喜欢不喜欢。收到几条颜色建议以后,申请类别是否容易选、错误后能否继续、提交状态是否可信,仍然没人知道。
评估性研究针对原型、产品或界面,检查它是否支持真实需要、是否容易使用,以及带来怎样的感受。先把问题写清,结果才有可能推动修改。
评估不只在上线前进行。早期概念、现有产品和不同保真度的原型都能评估,只是能回答的范围不同。
申请能提交,不等于申请功能有用
假设一个企业后台新增申请入口,团队需要检查三件事:这项功能是否支持实际工作,员工能否理解类别,提交后是否知道当前状态。
第一项要回到工作需要,第二项适合观察任务,第三项还需要核对状态与业务规则。点击次数回答不了这三项问题,喜欢视觉也不等于独立完成申请。
将有用性、可用性和感受分别安排。可以在同一场研究中收集,但报告不能互相替代:用户觉得轻松,仍可能漏选类别;操作顺畅,也可能没有解决值得投入的问题。
| 想判断什么 | 可以怎样获得材料 | 不能顺带证明什么 |
|---|---|---|
| 是否支持实际目标 | 情境研究和目标用户讨论 | 未来意愿不是已发生使用 |
| 能否完成申请 | 原型任务观察 | 成功路径不代表异常也可用 |
| 首次理解是否清楚 | 专家逐步检查与用户任务 | 专家推演不是用户行为 |
| 视觉带来什么感受 | 描述和解释性反馈 | 好感不等于操作成功 |
| 明确变化的行为结果 | 条件合适的对照研究 | 原型发现不是上线因果 |
先列核心问题、对象、任务与版本,说明本轮不回答什么。不要收一堆指标之后,再寻找能够支持方案的故事。
原型与环境,要能承受这次提问
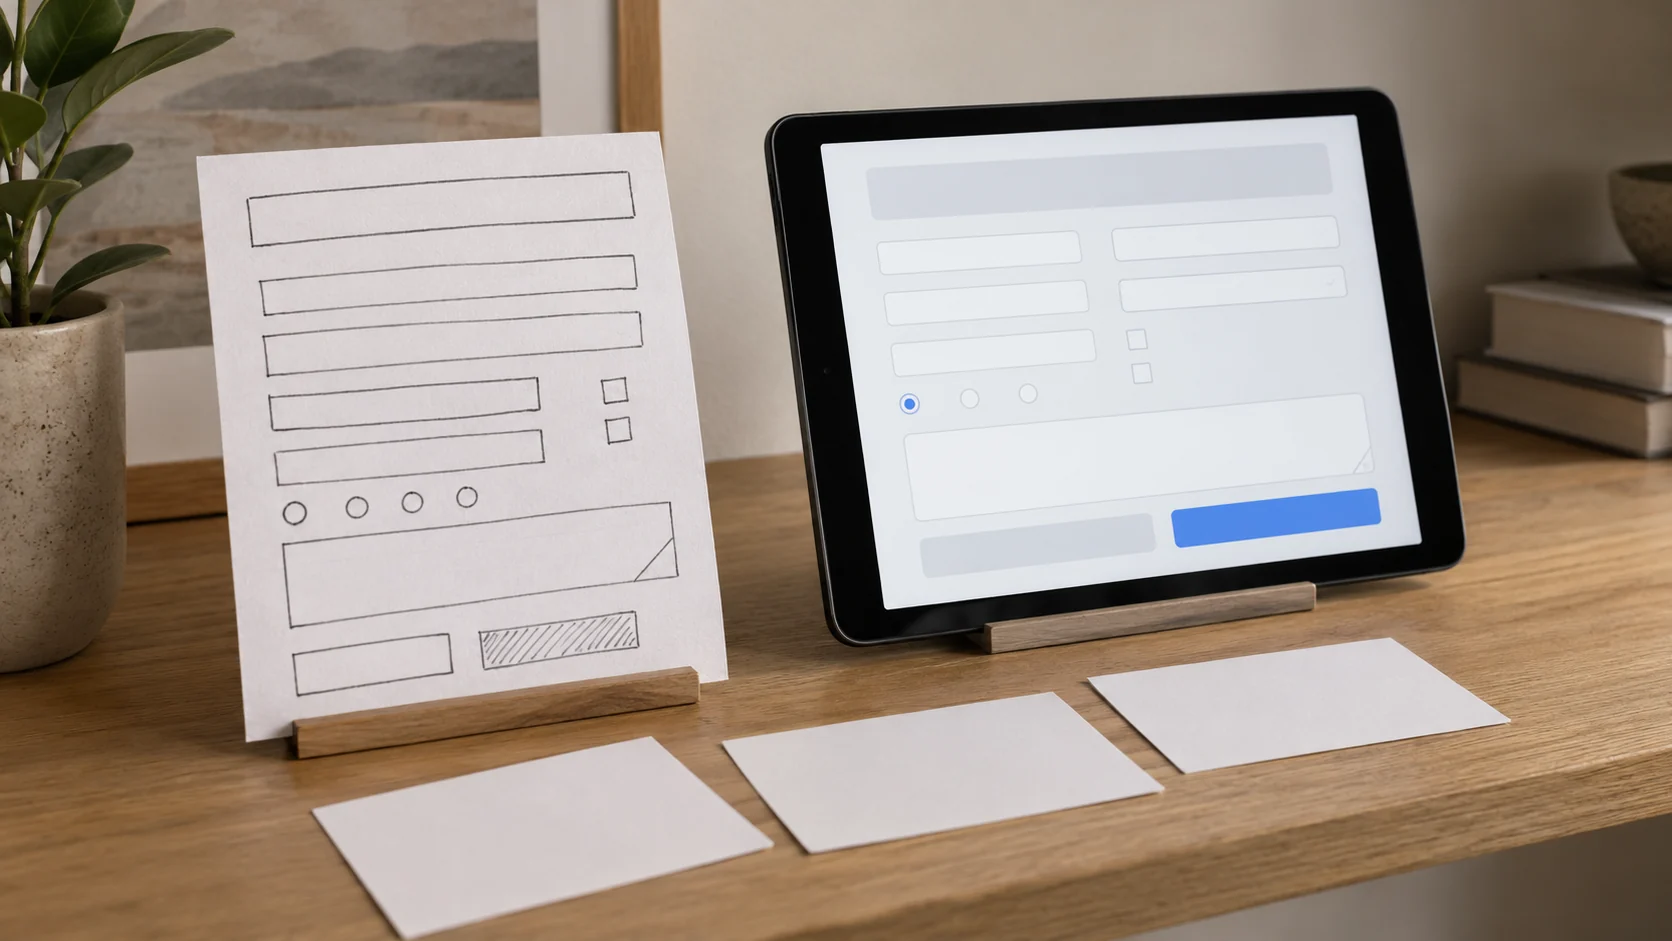
信息关系可以先用纸面原型检查,操作和反馈则需要能点击、能显示状态的原型。涉及空间或人员交接时,环境也要接近所研究的情境。
原型只有成功路径,就只能评估这部分。权限、错误和返回尚未实现时,明确标注,不让参与者以为那是产品的完整能力。
实验室便于控制条件,却可能漏掉实际干扰;现场更贴近日常,其他因素又较难控制。选择哪种环境,取决于问题,不是越真实或越精致越好。
专家检查可提前发现明显障碍,但评审者熟悉设计,判断基于推演。真实目标用户带来的知识、习惯和路径,常与团队不同。资源有限时,可以缩小核心任务,不宜只用内部意见替代用户。
任务不给答案,记录也不靠总体印象
任务描述目标,如“提交这次设备使用申请,并确认现在由谁处理”,不说该点哪个菜单。事先定义开始、完成、协助、错误和放弃怎样记录,再试跑确认原型和材料够用。
开场说明评估的是方案,不是考参与者。没有“表现不好”的用户,困难值得记录。主持人按约定提供帮助,并标明干预,不能把提示后的完成写成独立完成。
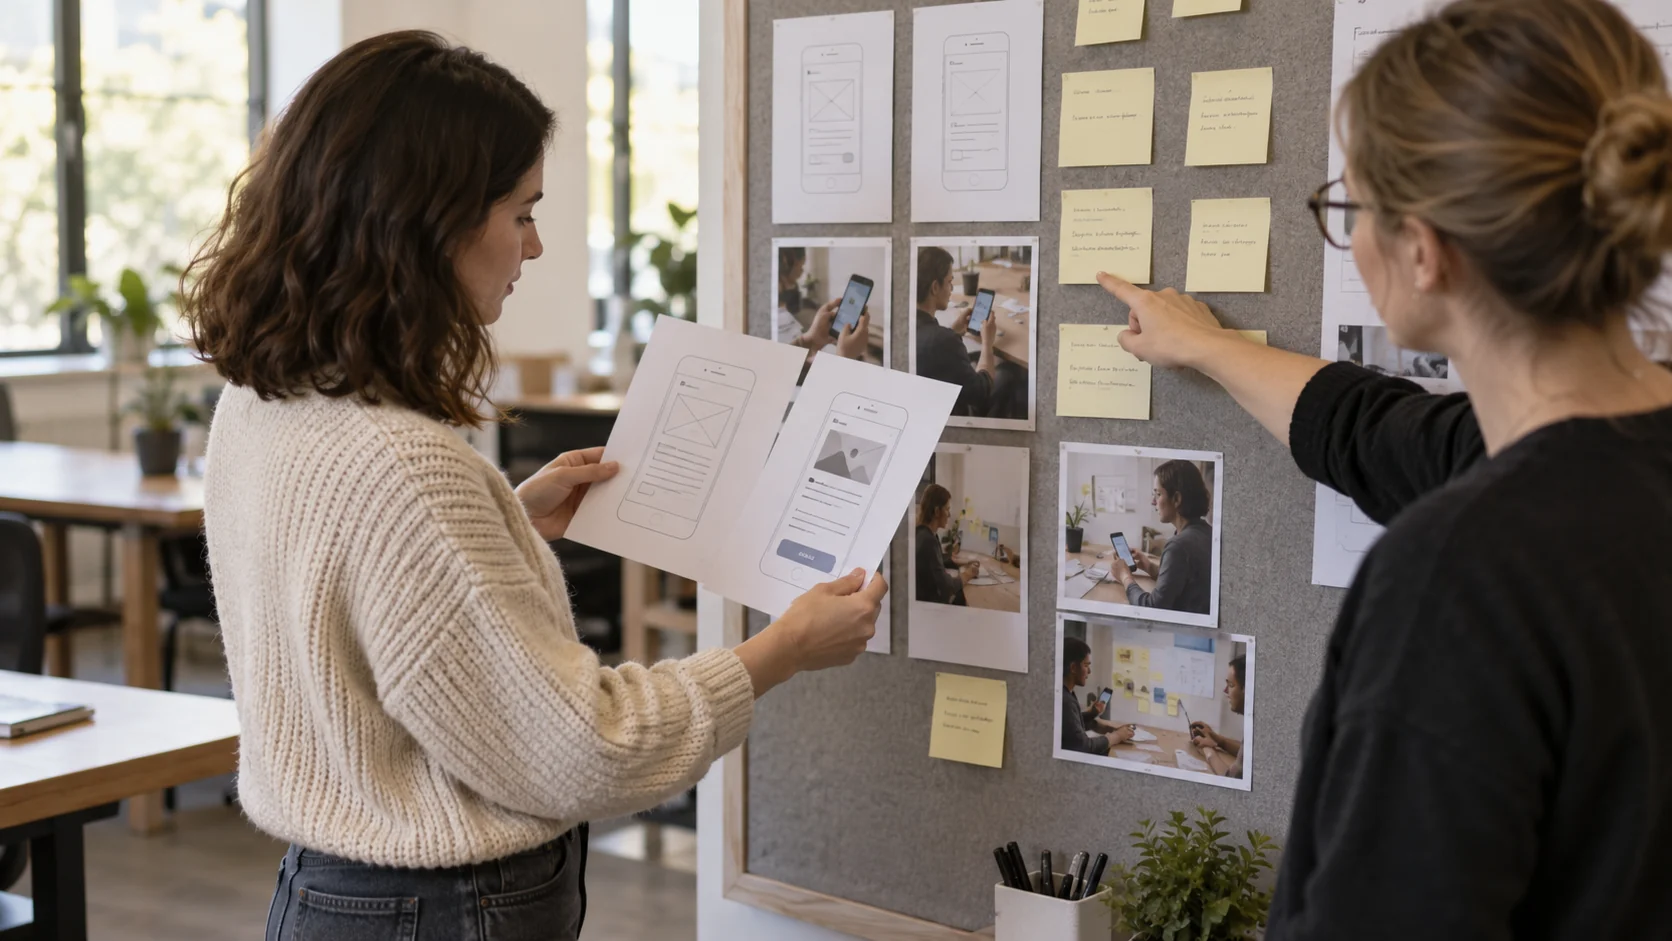
观察停顿、回退、类别选择和状态判断,再问原因。发现“员工选了其他类别”时,既要记录节点,也要听他怎样理解标签,不急着认定是不认真。
自动远程研究可以支持结构化任务,但工具不保证招募与任务适合。A/B测试适合条件允许时比较明确变化,与小样本原型研究所提供的证据不同。
修改之后,回到原来的问题
假设用户把两类申请混淆,团队调整名称和说明。复核时仍检查这项选择,并看看新增说明是否挡住下一步,而不是只问新版是否更漂亮。
不必每次重测全部内容,但影响核心路径时,需要检查前后连贯。低频但关键的错误也不能因为多数人顺利就被忽略。
成功标志:问题、相关行为、修订和复核结果能够对应起来;未解决项仍有责任和计划。这样的结果能支持决定,笼统一句“体验验证完成”反而容易掩盖范围。
报告说清通过了什么检查、涉及谁、采用什么版本和环境、仍有哪些限制。保存任务材料、观察与修改理由,也便于下一轮知道为什么这样设计。
58UI可为官网与数字产品安排UI/UX评估、原型设计和改版诊断,再衔接企业官网设计开发、品牌视觉及响应式适配。可以查看作品了解呈现范围,或联系58UI先确认最需要评估的任务。
相关服务